課題・問題
データ転送ツールの頻発するフリーズと各種システムでのデータのサイロ化により、正しいデータが不明瞭だった
まずは皆さまの簡単な自己紹介と、今回のプロジェクトでのお役割について教えてください。
宇田 亮二様(以下、敬称略):私は情報システム部のマネージャーを務めております。今回のプロジェクトでは、経営陣と現場開発の間に立って意思決定を進め、基盤刷新を統括しました。
津田 浩史様(以下、敬称略):宇田と同じく、情報システム部に所属しており、ディレクターを務めています。2022年の導入プロジェクト立ち上げの主担当として、「TROCCO」の選定やSnowflakeへの移行実務を担当しました。
現在はセキュリティ関連の業務に従事しておりますが、当時の課題感や「TROCCO」導入時のことについて詳しくお伝えできればと思います。
松元 孝樹様(以下、敬称略):私も同じく情報システム部で、リーダーを務めております。津田からプロジェクトを引き継ぎ、「TROCCO」の実装やデータ基盤の詳細設計、運用を担ってきました。
現在はClaude Codeなどの生成AIを実務に組み込み、開発の内製化や自動化、基盤のアップデートに取り組んでいます。
以前、データ活用ではどのような課題がありましたか。
津田:現場主導でkintoneや外部SaaSの導入が独自に進んだ結果、情報システム部門が各種ツールを管理しきれない状態に陥っていました。データを一つに集めれば管理できるのではないかという構想は立っていたのですが、具体的な方法はわかっていない状況でした。
宇田:データ管理の面だけでなく、ツール自体の安定性にも問題がありました。以前のツールはオンプレミス環境で稼働しており、サーバーの監視・管理が必要だったのです。処理が集中すると頻繁にフリーズし、データ連携が停止する問題に悩まされていました。
津田:加えて以前のツールは転送速度に課題があり、処理が重なるとフリーズしてしまうリスクもありました。サポートへの問い合わせも解決までに時間がかかることが多く、システムの安定稼働や日々の監視にかかる運用負荷を軽減したいと考えていました。
そうした課題を抱えるなかで、基盤を刷新することになったきっかけを教えてください。
宇田:2022年に、当時の部長の提案でSnowflakeを導入したことがきっかけでした。当初は『Snowflakeとは何か』を理解するところから手探りで始まりました。検証を進めるうちに、生データさえ格納できれば、その後の加工やSQL、Snowflakeの機能を用いて集計は自社で自由に作れると分かってきました。
津田:ただ、最大の問題は「どうやって生データを効率的にSnowflakeへ運び込むか」でした。移行前のツールはSnowflakeとの連携に正式対応しておらず、自己責任での対応が前提となる状況だったのです。これでは本番環境で安心して使い続けることは難しいと判断しました。
なぜ「TROCCO」を選んだのか
高い自由度と圧倒的な使いやすさ、そしてSnowflakeとのスムーズな連携
Snowflakeへデータを転送するにあたり、ツールの比較・検討などは行いましたか。
津田:はい、比較検討の段階では多くのツールを試しました。
ある協力会社からは「Pythonで書けばデータ連携はすぐ作れる」と自社での構築を提案されたこともありましたが、属人化のリスクが高く、将来的な運用を考えて断念しました。また、変更データのみを取り込む海外製ツールも検証しました。接続元のMySQLやSQL Server側のデータへの加工が必要なため、こちらも運用面から見送っています。
そうしたなかで、当時の部長に打診されたのが「TROCCO」です。実際に試してみると、その自由度の高さと使いやすさ、そしてSnowflakeへスムーズにデータを取り込める仕組みに驚いたことを覚えています。以前のツールとは違い、Snowflakeに正式対応している点が決め手になりました。
「TROCCO」の導入はスムーズに進みましたか。
津田:primeNumber社からのサポートもあり、非常にスムーズに進みました。特に、困りごとを即座に質問できる環境は心強かったです。専門知識を分かりやすく噛み砕いて説明していただき、非常に感謝しています。
また「TROCCO」は開発スピードが非常に速く、やりづらさを感じた点が1〜2ヶ月後のアップデートで改良されることも多いです。繰り返し処理やメモリ割り当ての調整機能も充実しており、複雑なデータ移行にも難なく対応できています。
現在のシステム構成とデータの使い分け
「TROCCO」とSnowflakeネイティブ機能の使い分け
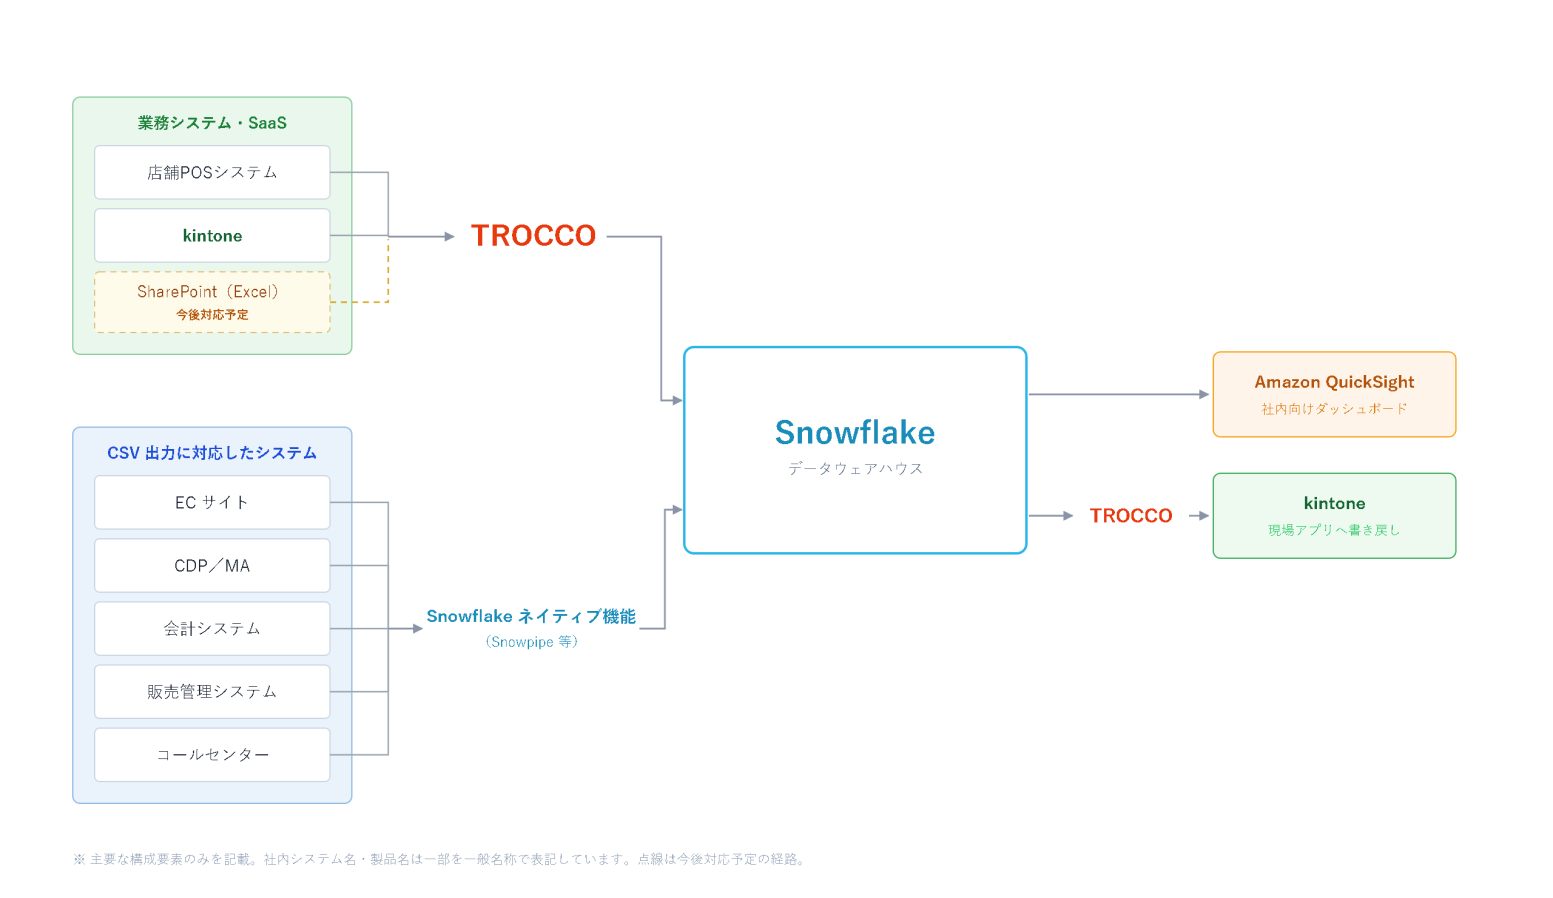
現在のデータ連携のシステム構成と、それぞれのツールが担う役割を教えてください。
松元:現在は「TROCCO」で各システムのデータを集め、Snowflakeに格納し、Amazon QuickSightで可視化、kintoneで業務メモを管理する構成です。
基幹システムやkintoneの生データを「TROCCO」経由でSnowflakeへ集約するだけでなく、Snowflakeで加工したデータを再びkintoneに反映させる仕組み(リバースETL)も実現しました。
ECサイトや店舗POSデータなどの転送は、どのように使い分けているのでしょうか。
松元:転送方法は、データの性質によって使い分けています。全国のサロンや店舗のPOSレジデータは、「TROCCO」経由でSnowflakeに集約する形です。
その一方で、ECサイトなどのデータはCSV出力に対応しているため、Snowflakeの機能であるSnowpipeで直接転送しています。CSV対応ならSnowpipe、非対応なら「TROCCO」と適材適所で使い分けることで、最適な体制を構築しました。
BIツールであるAmazon QuickSightと、kintoneの活用方法についても教えてください。
松元:Amazon QuickSightとkintoneは、業務フロー上で扱うデータが「定量か、定性か」という点で使い分けています。
定量データを担うのがAmazon QuickSightです。売上などの数値データを可視化しており、閲覧ユーザー数は約450名を超えています。バックオフィスを除く店舗スタッフやマネージャーのほぼ全員が日常的に使用できる状況です。
それに対して、定性データを担うのがkintoneです。数値には表れない現場の業務記録を蓄積しています。このような定性データについても、「TROCCO」を介してSnowflakeへ集約した上で、業務で使う形に加工してkintoneへ戻す運用をしています。
社員の6割以上が日常的にBIツールを使いこなしていらっしゃるとのことでした。ここまで現場に浸透した背景には何があるのでしょうか。
津田:当社では2008年にBIツールを導入して以来、全店舗で売上や日報を確認する文化がありました。BIツールが変遷しても、営業終了後に売上や目標達成状況を細かくチェックする習慣は、もともと現場に根付いていたという点も大きかったと思います。
松元:商業施設内に出店している店舗では、営業終了後に施設側へ売上を報告する業務があります。ここでは店舗スタッフがAmazon QuickSightからデータをダウンロードし、そのまま提出しています。このように、弊社では現場の通常業務においてもデータ基盤、ダッシュボードが当たり前に使われています。
導入後の効果
「守り」の問い合わせ対応を数分〜10分に短縮し、生まれた時間で「攻め」の設計改善へ
「TROCCO」導入後の成果について教えてください。
宇田:最も大きな成果は、フリーズが一切なくなり、監視にかかる負担が大きく軽減されたことです。
以前のオンプレミス環境では、週末や夜間にフリーズが起きるリスクが常にあり、気の休まらない状態でした。「TROCCO」導入後は30分おきの自動実行に加えて、リカバリーも自動で行われるため、安心して任せられるようになりました。
松元様は、primeNumberのユーザー会でClaude Codeを活用した取り組みを発表されたと伺いました。AI活用前の課題を教えてください。
松元:現在、開発や運用にClaude Codeを全面的に活用しています。これまで協力会社へ外注していた開発タスクも、現在はAIの力を借りて完全に内製化する方針へ切り替えました。
要件定義からコーディング、テスト作成まで幅広く活用し、開発工数を大幅に削減しています。その中でも特に大きな成果が、データ不整合に関する社内問い合わせへの対応の高速化です。元々、1回の調査に最大7時間以上かかることも珍しくありませんでした。
Claude Codeの導入によって、実務面でどのような成果が得られましたか。
松元:今ではわずか数分〜10分程度に短縮されました。課題解決が早くなったことにより、本来集中すべきデータ基盤そのものの改善業務に力をかけられるようになりました。
現在のデータ基盤の改善点を洗い出す際にClaudeから差分転送機能を取り入れてはどうかと提案されました。そこで、100個以上ある転送設定をClaude Codeを使ってTROCCO API経由で切り替えました。
松元様のprimeNumber User Groupでの登壇資料はこちらからご覧ください。
今後の展望
テーブル設計の再構築から、問い合わせ対応の全自動化へ
直近で注力されているデータ基盤の整備や、展開中の取り組みについて教えてください。
松元:直近では、Snowflake内のテーブル設計の見直しに取り組んでいます。現状は売上などの重要なKPIを持つテーブルが乱立し、同じ指標でも値が微妙にずれてしまう問題が起きているためです。そこで、参照先を一本化するための再設計を進めています。
具体的には、メダリオンアーキテクチャのような形でテーブルを整理していく方針です。こうしておけば、将来AIがデータを利活用する際にも、正確なデータを迷わず引き出せるようになると考えています。
宇田:当社では、社内情報を集約したAIエージェントの全社展開も進めています。
その一方で、まだまだ課題も残っています。情報システム部が直接管理していない業務領域では、まだExcelなどを使った運用が残っており、データ連携やAI活用に踏み込めていない部分があります。
今後はこうした領域にもAIを組み合わせて誰もがデータを有効活用できる形にしていき、会社の利益やコスト削減に直接貢献できる仕組みへアップデートしていきたいと考えています。
今後、どのようなデータ活用の姿を目指していきたいとお考えですか。
松元:今後は、問い合わせの「一次対応の完全自動化」を実現したいです。Slackに質問が投稿されたらAIエージェントが自動で原因を調査して一次回答を返し、私たちはその内容が正しいかどうかを確認する「スーパーバイザー」役に徹する、という体制を目指しています。
データ活用やデータ基盤の構築で悩まれている企業のご担当者様に向けてのメッセージをお聞かせください。
津田:世間では高度なSEがいないとデータ基盤構築は難しいと思われがちですが、「TROCCO」は専門知識がなくても直感的に使える点が魅力です。技術力がないと諦めている企業にとって最適なツールになってくれると思います。
宇田:サイロ化したデータを、まず一箇所へすべて集める決断が大切です。まとめることでデータ同士が繋がり、事業を見つめ直した時に新たなビジネスの発見が生まれます。そのため「TROCCO」は、それを最も安全かつ容易に実現してくれる素晴らしいツールだと思います。
松元:データ活用に悩まれている方に私が一番おすすめしたいのは、primeNumber社が運営されているコミュニティ「primeNumber User Group」への参加です。
普通ならコンサルを入れなければ解決できない専門的な悩みも、ユーザーコミュニティなら同じ課題を抱える仲間とざっくばらんに話し合いながら、その場でヒントを見つけられます。しかも、これだけの場が無料で提供されていることは、本当に大きな強みだと感じています。
ツールの機能比較も大切ですが、それ以上に「同じ立場で困っている人同士がオープンに悩みを話し合えるコミュニティ」自体に、大きな価値があります。データ活用に行き詰まった時は、ぜひ「primeNumber User Group」に足を運んでみてください。そこには探しているヒントや解決の糸口がきっと見つかるはずです。
「TROCCO」に興味がある方はぜひお気軽にお問い合わせください。